
Un ami a qualifié ma façon de travailler de « vibe coding » après que je lui ai décrit comment j'utilise des agents IA, des outils capables d'explorer un projet, de modifier du code et de lancer des vérifications. Le raccourci était compréhensible. Je décris un besoin, des agents explorent mes projets et produisent une grande partie du code. Pourtant, je ne me reconnais pas dans cette expression. Ce qui compte n'est pas la quantité de code écrite par l'IA, mais la maîtrise que je conserve sur ce qui est construit.
Ce que recouvre le vibe coding
Dans sa publication du 2 février 2025, Andrej Karpathy, chercheur en IA, décrit une pratique où il laisse l'IA produire le code, accepte ses changements sans toujours relire les modifications apportées au code, teste le résultat et lui renvoie les erreurs. Il évoque notamment des projets personnels et jetables. Le terme s'est depuis élargi jusqu'à désigner, parfois, toute application construite à l'aide d'une IA.
Cette extension brouille une distinction utile. Deux personnes peuvent demander à un agent de produire une fonctionnalité entière et obtenir le même résultat apparent. L'une sait juger les choix d'architecture, de sécurité ou de maintenance ; l'autre peut difficilement évaluer ce qui se passe derrière l'interface. La proportion de code généré ne permet pas de distinguer ces situations.
Je ne cherche pas à disqualifier l'expérimentation par ceux qui ne développent pas. Elle rend la création de logiciels accessible à davantage de personnes. Mais lorsqu'un système doit durer, être exploité et évoluer, quelqu'un doit pouvoir répondre de ses décisions importantes.
J'ai aussi croisé le terme « LARPer », qui évoque le fait de jouer un rôle en ligne. L'ADN en décrit l'usage général sur les réseaux. Je n'ai pas retrouvé la publication qui l'appliquait aux créateurs d'applications IA ; je m'en tiens donc à cette mention.
Générer n'est pas décider
Je peux demander à un agent d'implémenter une API sans lui laisser choisir l'architecture générale, ou refuser une correction qui fonctionne mais introduit une dépendance disproportionnée. Une compilation réussie ne garantit pas une bonne solution ; un test peut passer tout en vérifiant la mauvaise chose.
Je place donc la frontière dans cette question : suis-je capable de comprendre les décisions structurantes, de déceler une mauvaise direction et de reprendre la main ? Je n'ai pas besoin de taper chaque ligne ni de suivre chaque opération de l'agent. J'ai besoin de savoir ce que je lui ai délégué et comment juger le résultat.
Ce que j'orchestre concrètement
Je pars d'un besoin que je discute avec un modèle de langage (LLM) dans une interface web, souvent ChatGPT. Cet échange m'aide à formuler le problème ; il ne modifie pas le projet. Je transforme ensuite la réflexion en descriptif de fonctionnalité ou en cahier des charges : objectif, contraintes, périmètre et résultat attendu. Je centralise ce travail dans un ticket sur GitHub, GitLab ou Gitea. Le ticket devient la table de travail que je partage avec l'agent et où je garde la trace du cadrage, des décisions et des échanges.
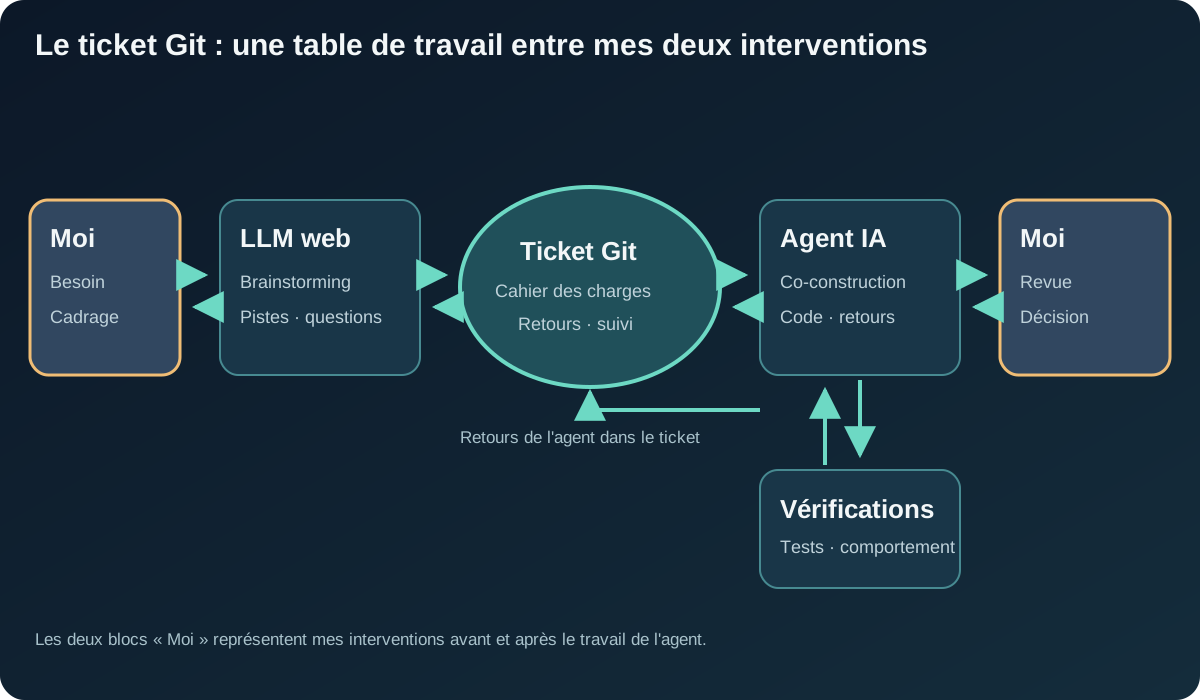
Le ticket réunit mon cadrage, les retours de l'agent et mes décisions.
Le schéma place mon échange avec le LLM web avant le ticket, puis mon travail avec l'agent de développement après celui-ci. Cet agent accède au ticket et au projet via sa connexion à la plateforme Git : il peut explorer les fichiers, proposer une solution et l'implémenter. J'échange avec lui dans le ticket ou dans notre session de travail, questionne ses choix, ajuste le cadrage et vérifie le résultat. Il consigne aussi ses questions, propositions et retours d'exécution dans le ticket. Auparavant, je rassemblais ce cadre de travail dans des fichiers Markdown ou texte ; la plateforme Git en est désormais le centre.
Je ne suis pas chaque ligne pendant que l'agent écrit. Mon contrôle porte sur le comportement obtenu, les décisions d'architecture et les règles qui doivent rester vraies. Pour une API, par exemple, je vérifie qu'une fonctionnalité répond au besoin et qu'un utilisateur sans les droits requis ne peut toujours pas y accéder. Les tests, la revue des changements dans Git et un essai manuel du parcours dans l'application me donnent des éléments pour en juger. Si l'agent s'écarte de l'objectif, je réduis le périmètre, corrige le contexte ou interviens directement.
L'agent peut aussi signaler un cas limite ou une contrainte que je n'avais pas vue. En retour, mon expérience peut révéler ce qui lui manque : une règle métier implicite, une particularité de l'infrastructure, un risque à l'exploitation. Nous avons chacun des angles morts ; confronter nos propositions améliore le diagnostic.
Je documente aussi l'évolution de ce processus en vidéo sur ma chaîne YouTube TED JB 81. Ces sessions montrent comment ma manière de cadrer et de déléguer le développement change avec les outils.
Une compétence supplémentaire du développement
Développer ne s'est jamais limité à écrire du code. Il faut comprendre un besoin, faire des compromis, concevoir, tester et maintenir. Les agents prennent désormais en charge une partie de l'analyse et de l'implémentation. Pour leur déléguer efficacement une tâche, je dois souvent mieux formuler le problème, les limites de leur autonomie et ce qui constitue un résultat acceptable.
Mon expérience me sert alors autant à cadrer le travail qu'à évaluer ce qui a été produit. Elle m'aide à repérer une structure générique ajoutée avant qu'un besoin réel la justifie, une solution disproportionnée ou un problème plus large que celui décrit dans la demande. Savoir coder reste utile pour comprendre le système et intervenir quand la délégation atteint ses limites.
Pour l'instant, orchestration est le mot qui décrit le mieux ma pratique. L'agent explore, questionne et produit ; je définis les conditions de son autonomie, confronte ses propositions au réel et assume la solution livrée. Le marché trouvera peut-être un autre terme à mesure que ces pratiques évolueront. Le nom reste ouvert ; la responsabilité de comprendre ce que l'on construit, elle, demeure.